2026 · AI APPLICATION ENGINEERING

ISSUE 01
AGENT / EVAL / PRODUCT

把系统做成可运行,
也把边界写成证据。

三条求职证据线,不是 68 个仓库的功能清单: 一条讲平台工程,一条讲评测与审计,一条讲真实用户产品。 每个入口都能看到输入、输出、失败路径,以及它不证明什么。

90 秒阅读路径

  1. 01先看一条失败路径,而不是成功截图。
  2. 02再沿着指标找到 JSON、SQLite 或审计链。
  3. 03最后读边界,判断这条证据能支撑什么岗位。

SELECTED WORK / 三条证据线

不是一个“AI 万能工程师”,
是三类可验证的交付能力。

01

AGENT / PLATFORM

↳

Agent 平台工程

agent-platform

可运行 · 本地实时

一条客服工单穿过网关、订单库、工具沙箱、记忆压缩、LLM 和可观测层。 这个项目专门回答:为什么单模块全绿,端到端仍会坏?
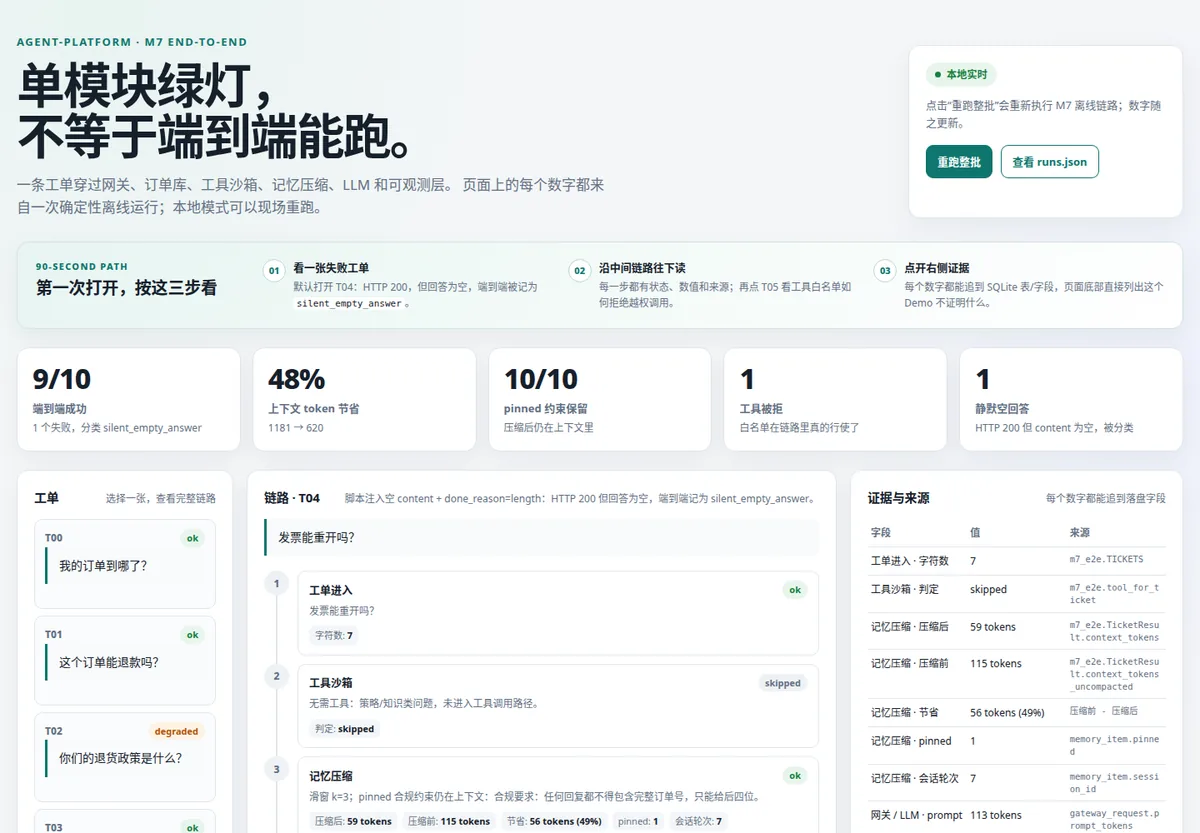
agent-platform 工单链路 Demo:默认展示 T04 静默空回答 OPEN DEMO ↗
用户
需要判断 Agent 链路是否真的端到端可用的平台工程师
输入
10 张确定性离线工单与 M1–M9 结果文件
输出
六步链路回放、失败分类、SQLite 字段来源与模块门禁
关键证据
T04 静默空回答、T05 工具越权拒绝、实时重跑后元数据变化

EV-01 Demo 契约测试 16/16;M1–M9 共 11 个模块证据卡;本地浏览器验收通过。

边界 LLM 回答由脚本上游生成;工单手写;延迟只是观测值,不是 SLO。

90 秒:T04 的空回答 → T05 的工具拒绝 → 点重跑,看构建元数据变化 → 读页面底部 refutes。
02

LLM / EVALUATION

↳

LLM 评测工程

llm-lab

可复现 · 零 Key Demo

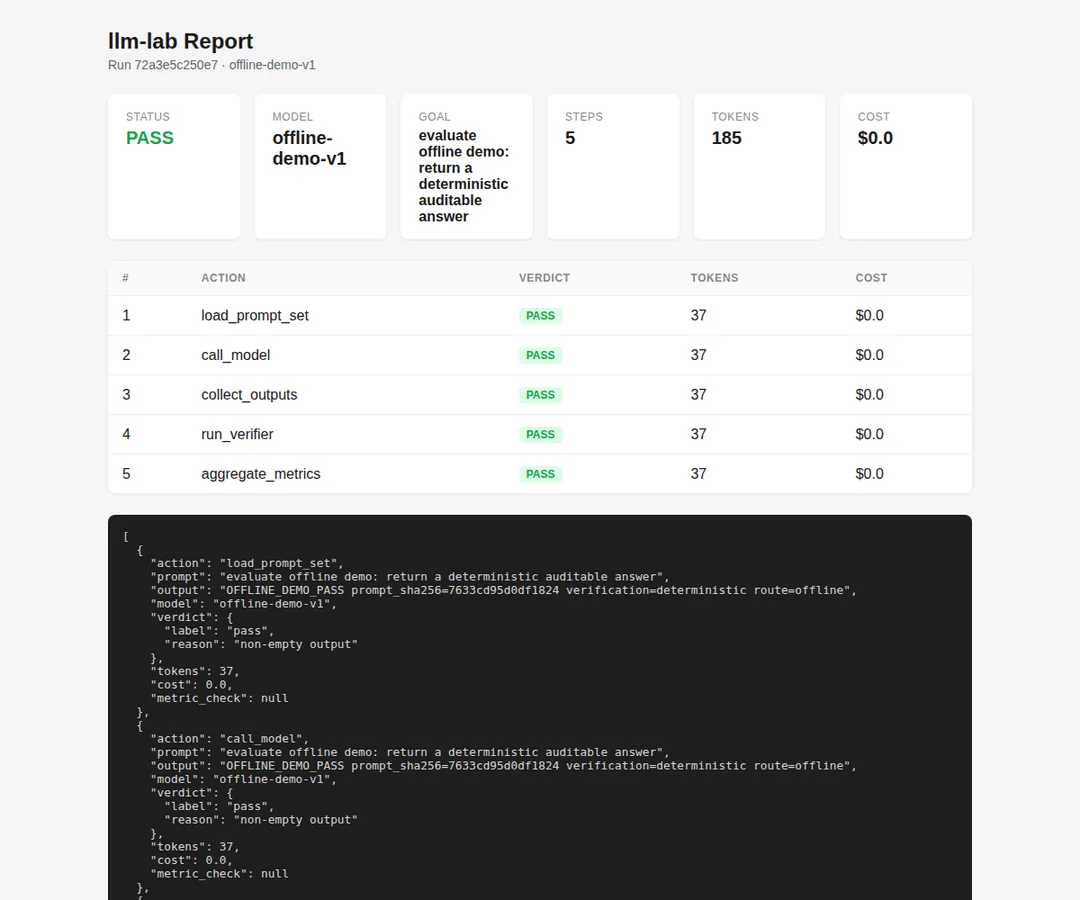
计划任务、调用模型、验证输出、写入哈希链审计日志。 无 API Key 的离线模式先证明编排与审计可以重放, 不用一个漂亮分数冒充模型质量。

llm-lab 离线报告:5 个步骤全部 PASS,总成本 0 美元 OPEN REPORT ↗
用户
需要本地评测、成本记录与可追溯证据的 LLM 工程师
输入
任务目标、模型配置、Verifier 与确定性离线 Provider
输出
result.json、独立 HTML 报告、5 行哈希链 SQLite 审计日志
关键证据
5/5 步骤 PASS;5 行审计链 OK;成本 $0.000000;命令退出码 0

EV-02 产品包 391 passed / 2 skipped;根自演化套件 106 passed;Ruff、Mypy 通过。

边界 offline-demo-v1 是测试夹具,不是 LLM;它证明管线,不证明模型质量或榜单能力。

90 秒:llm-lab demo → 5 个 PASS → 5 行审计链 → 读“不证明模型质量”的边界。

03

PRODUCT / USER

↳

真实用户产品

study-buddy

Demo 通过 · 用户待验证

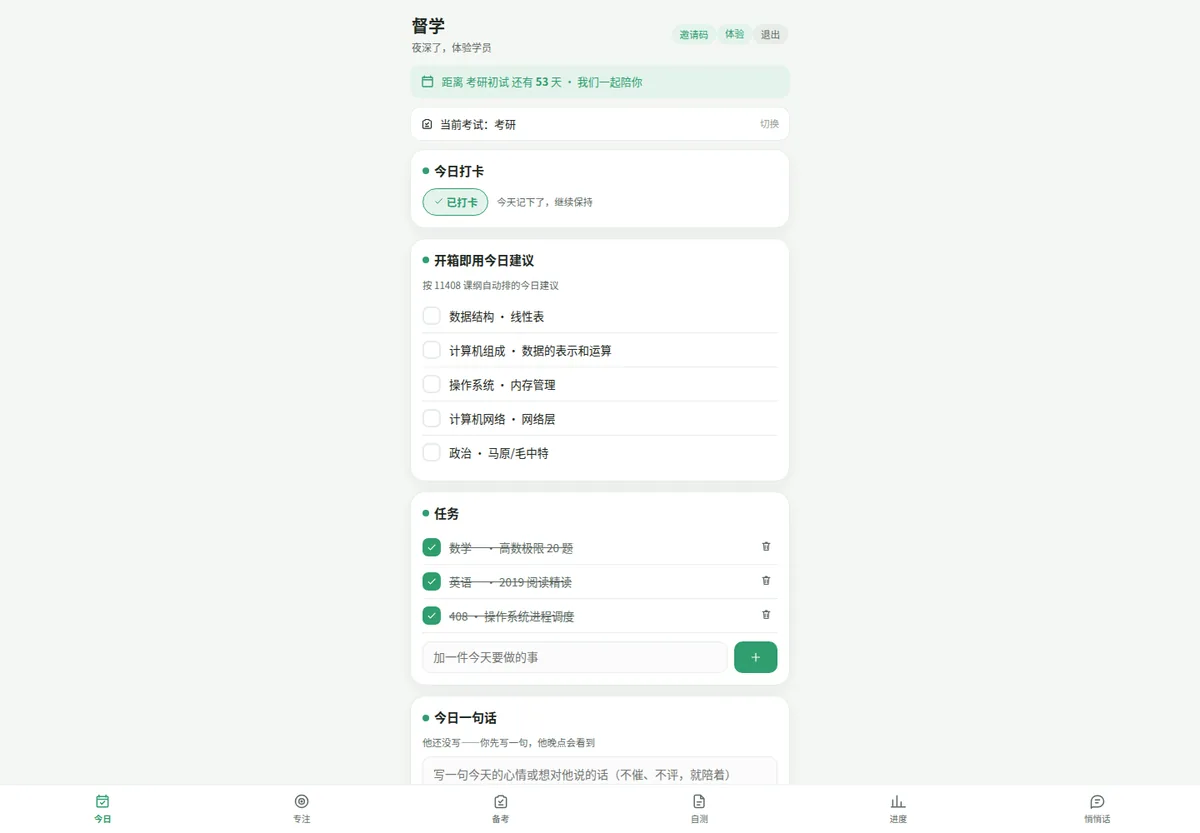
给考研长线备考者用的移动端督学 PWA:打开就有今日建议, 能勾任务、开番茄钟、看进度,也保留树洞与双人陪伴。 这不是“又一个功能很多的 App”,而是一个等待陌生人检验的首次使用路径。

study-buddy 手机端今日任务页面,包含今日建议、任务和打卡 TRY DEMO ↗
用户
需要长线陪伴与低决策负担的考研备考者
输入
今日任务、番茄钟、自测、打卡,以及本地/云端二选一的数据路径
输出
今日行动列表、专注记录、30 天热力图、阶段目标与隐私边界
关键证据
11 项单测 + 题库校验全绿;浏览器任务状态持久化;手机无横向溢出

USER-00 真实用户 0;首任务完成 0/0;48 小时回访 0/0。招募尚未开始。

边界 本地验收使用合成数据;云端同步、真实 iOS/Android 稳定性、留存与消费级通过均未验证。

90 秒:打开今日建议 → 勾掉 408 任务 → 看专注与 30 天热力图 → 明确“0 个真实用户”。

+

TECHNICAL SUPPLEMENT

rag-qa:把检索和生成拆开评

BM25 ⊕ 向量混合检索、强制引用、证据不足拒答,16 题正负样本。 离线复测 structure 策略 recall@5 为 10/12, fixed 为 9/12;负样本拒答两组均为 4/4。

EVIDENCE LEDGER / 证据账本

数字从哪里来,失败在哪里,
一眼能追到。

本次本地核验时间:2026-10-27。公开站的状态与本地新改动分开表述。

证据线 已运行 结果 不能推出
agent-platform Demo 契约 + gates + Chromium 16/16 · PASS 真实客服流量、真实 LLM 可用率、SLO
llm-lab Ruff + Mypy + Pytest + CLI Demo 391 passed · audit OK 模型质量、榜单名次、生产可靠性
study-buddy 单测 + 题库 + 构建 + Chromium 11 passed · ALL_OK 真实用户可完成、留存、消费级通过
rag-qa Pytest + --offline 复测 6 passed · 10/12 真实 embedding、在线生成质量、30+ 题泛化
01 / RUN

命令可重放

每条结论都对应本地命令、退出码与落盘产物;不是凭记忆复述。

02 / TRACE

结果可回读

JSON、SQLite、哈希链、截图或浏览器状态至少保留一种可检查证据。

03 / REFUTE

边界可证伪

合成数据、小样本、离线 Provider 和 0 个真实用户都主动写在结果旁边。

HONEST BOUNDARIES / 说清楚

面试里最贵的不是“会”,
是把不会的地方说准。

消费级状态

0 个真实用户,
没有留存结论。

study-buddy 目前只有本地合成 Demo 验收。10 人内测的招募、首任务、48 小时回访都是 0/0。

评测状态

审计链可验证,
不等于模型更强。

llm-lab 的离线 Provider 是固定响应夹具。真实模型比较需要另配 Provider、预算与新的评测计划。

平台状态

端到端链路真实,
上游仍是脚本。

agent-platform 的失败注入、订单库、工具白名单与 SQLite 回读是真实代码;LLM 内容和工单不是生产数据。

岗位表述

做 AI 应用工程,
不冒充研究科学家。

研究仓库作为背景证据,不用论文数量替代可运行系统、评测纪律和产品判断。

INTERVIEW NOTES / 可能被追问

四个问题,不看稿也能答。

为什么 68 个仓库只保留 3 条旗舰线?

面试官不是在数仓库,而是在判断能否把问题、工程、证据和边界讲闭环。68 个半成品会把主线稀释;其余仓库改为研究背景和技术广度。

哪个项目最能代表你?

agent-platform 代表系统拆解与失败分类;llm-lab 代表评测、审计和可复现;study-buddy 代表用户路径与产品克制。三条线对应岗位里的三种日常。

没有真实用户,为什么还放产品项目?

因为产品判断和用户验证是 AI 应用工程师的重要能力,同时必须把 0 写出来。这个项目现在证明的是首次路径、构建质量、隐私选项和验证计划,不是留存。

下一步最应该补哪条证据?

优先完成 study-buddy 的真实 10 人内测并修前三项摩擦;其次为 llm-lab 接一个成本受控的真实模型对照。两项都需要新的外部授权,不在本地静态证据里冒充完成。

END NOTE

作品集不是把所有东西做得很满,
是让每条主张都经得起追问。